AI 工程師與他的 Agent 軍隊

我一直在 Podcast 裡說,AI 是新的 UI。
以前我們操作介面,現在我們交代意圖,讓 Agent 去操作工具、完成工作。工程師的工作,也越來越像在管理一群會寫程式的 Agent。
我自己平均每個月花在 AI 工具、模型與 token 的支出,已經超過一萬美元。開發確實變快了,但有一件事沒有跟著變快:我的驗收速度。
我現在一個禮拜大概會提出一百多個 PR。這不是同時開了多少 Agent,也不代表每個 PR 都已經合併,但足以讓驗收變成每天都得面對的工作。
如果每份成果都要我從頭檢查,開再多 Agent,最後還是排隊等我。
之前在〈我們都在剎不住的時代列車上〉裡,我說人類是整個工作流裡最慢的部分。現在這個問題更具體了:我要怎麼知道,Agent 真的做完了?
這有點像叫人開車。「往北走」只給了方向,「去台北 101」才有明確目的地。但目的地講清楚,也不代表沿路可以逆向、闖紅燈,或為了抄近路開進別人家。
交給 Agent 也是一樣。我們要說清楚做到哪裡算完成,也要把車道收斂:哪些路能走、哪些操作不能做、碰到什麼狀況得停下來。這些就是規格、驗收、系統設計與權限邊界要一起處理的事。
多開 Agent 之前,我憑什麼放心?
最近看 Lauren Tan 分享 Agent 開發,她畫了一張信任曲線。縱軸是信任,橫軸是 Agent 數量。這是她的個人經驗示意,並不是量化研究。
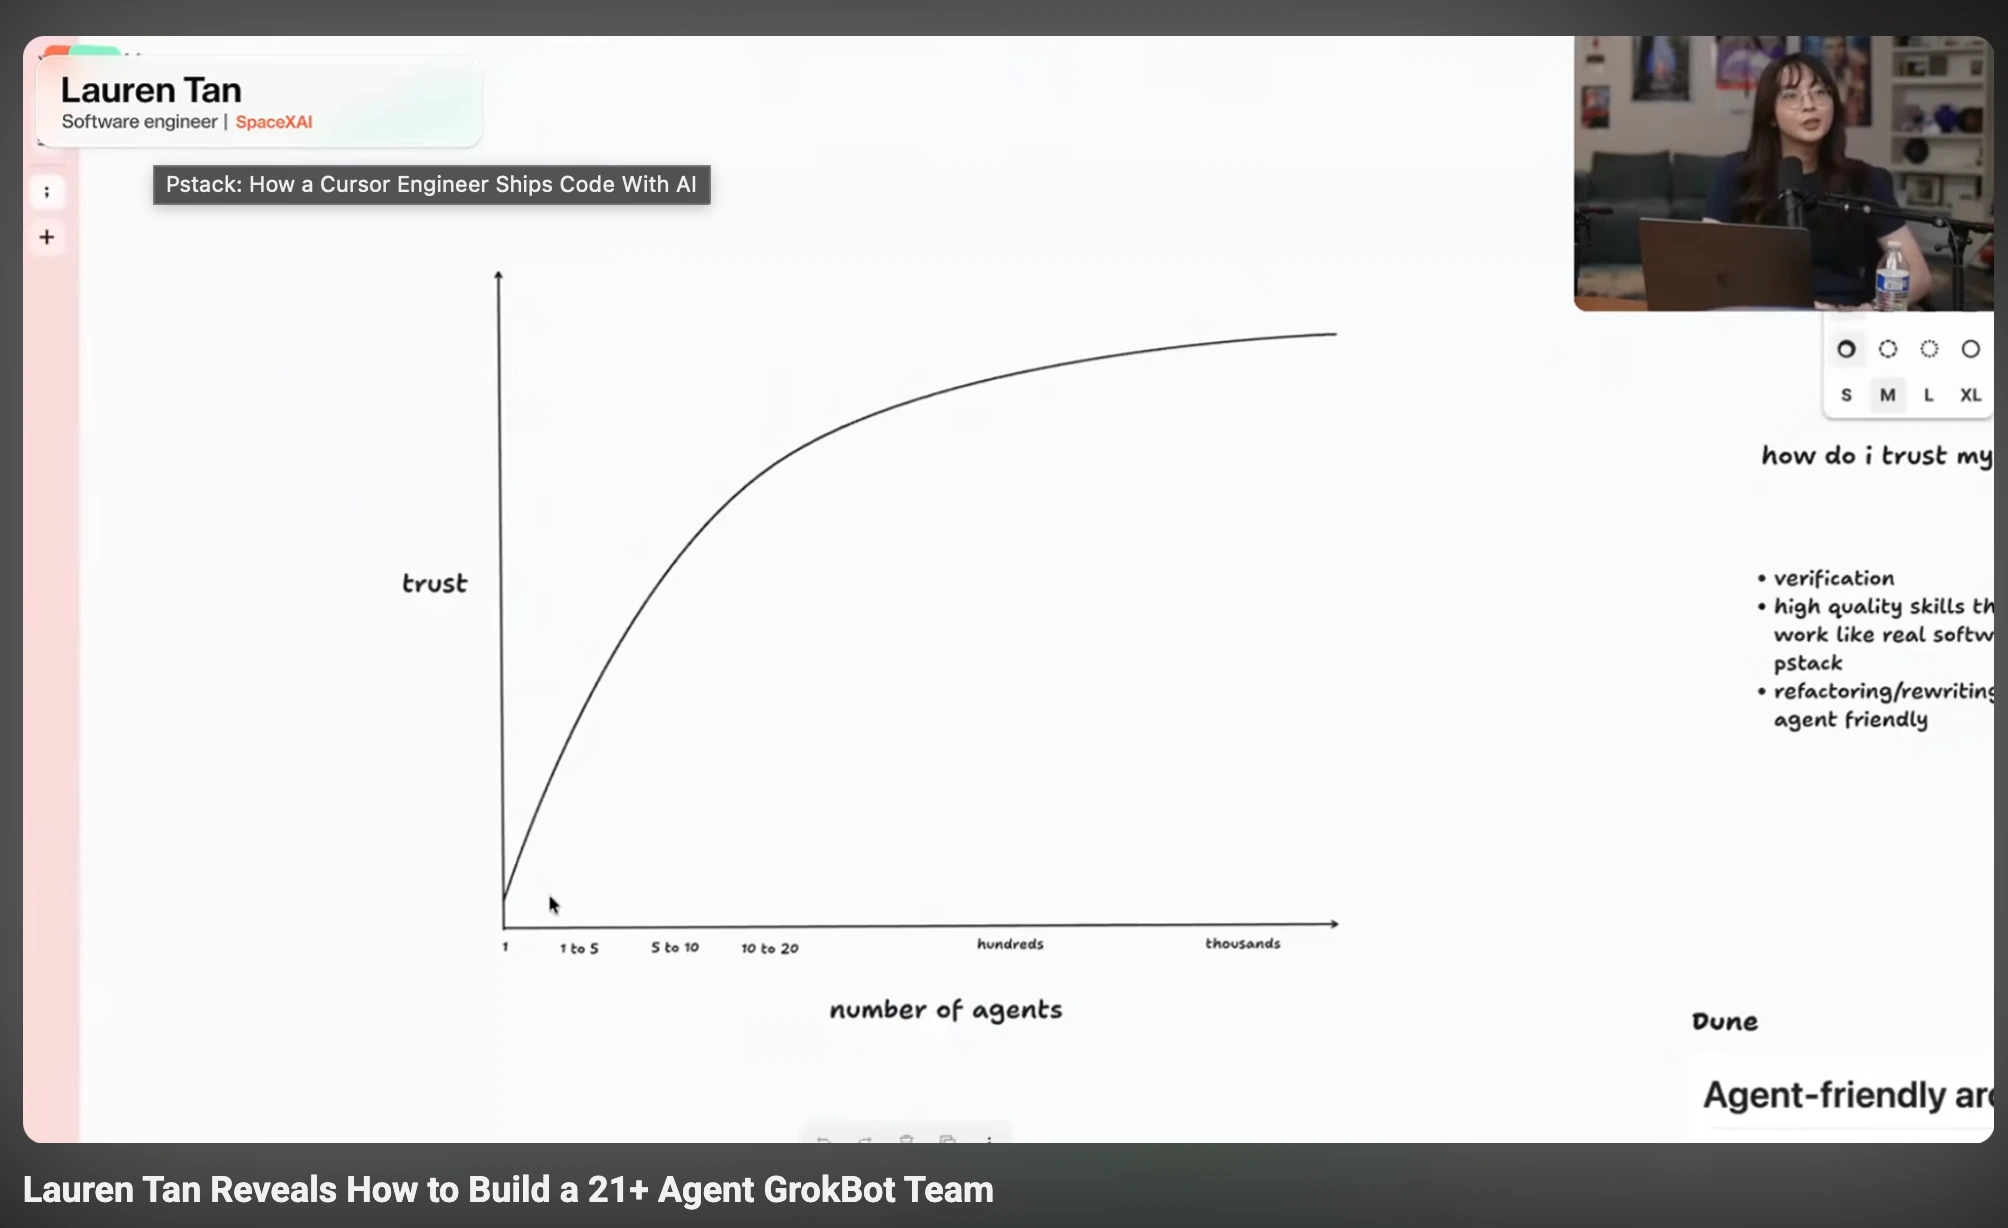
Lauren Tan 的個人經驗示意圖。來源:分享錄影約 2:08 起;並非量化研究結果。
我想到的是,如果連一個 Agent 的成果都要逐項盯著,要怎麼接住十個?
我平常會參考不同資深開發者的做法,最近也滿常用 PStack 的 mode。這些分享幫我整理工作方式,但最後還是要回到自己的系統:驗收的依據在哪裡?
查雲端狀態、翻執行紀錄、確認資源有沒有清乾淨,如果這些都要我親手做,平行工作的上限就是我的注意力。
Agent 得能自己取得驗證結果,留下證據,再把需要判斷的事交回來。
規格之外,Agent 還得知道怎麼驗證
知道程式碼在哪裡,和知道系統怎麼使用,是兩回事。
就算需求寫清楚了,Agent 不知道怎麼啟動環境、準備資料、觸發任務,最後還是只能讀程式,猜它應該會怎麼運作。編譯通過、測試全綠,也可能一進到實際流程就卡住。
我覺得 feature map 很有用:把功能入口、操作方式、預期結果,以及去哪裡確認結果,整理成 Agent 能使用的路徑。
以算力派發來說,除了程式本身,我還得讓它知道:任務從哪裡送出、需要哪些測試資料、去哪裡查資源狀態、結果存在哪裡,以及失敗後怎麼找到還沒清掉的資源。
簡化的驗證路徑可以長這樣,這是示意,不是內部系統的設定:
| 階段 | 操作與檢查 |
|---|---|
| 準備 | 使用測試環境,為本次任務留下可追蹤的識別碼。 |
| 執行 | 送出任務,記錄它建立的資源;在約定期限內查詢是否準備好。 |
| 核對 | 檢查任務輸出,再查雲端的最終資源狀態,保留查詢結果。 |
| 失敗 | 保存錯誤、嘗試清理,列出仍未釋放的資源,不能只回報失敗。 |
這些操作知識如果只在我腦中,每一個 Agent 都得重新問我一次。把它留下來,下一次才能重複使用,也才能在驗證失敗後,沿著同一條路徑繼續查。
「做完了」要有可以對照的結果
拿我在做的算力派發來說,需求可以很簡單:在指定的雲端開一個資源,執行任務,做完再關掉。
但資源建好了,就能執行嗎?任務結束了,結果有存下來嗎?中途失敗,資源誰關?
這整段才是我要驗證的行為。
精簡的 unit test 一定要有。狀態轉換、失敗後有沒有呼叫清理,都可以用模擬回應快速檢查。但任務入口、雲端 API、執行環境、結果保存各自通過,不代表接起來也能用。
所以我更想把關鍵流程的 E2E 做完整,讓 Agent 有一組固定的錨點:
- 建立資源:雲端與區域正確,而且資源真的準備好了。
- 執行任務:工作在這個資源上執行,取得預期輸出。
- 保存結果:資源清掉以後,結果仍然拿得到。
- 釋放資源:本次建立的資源,到達約定的停止或刪除狀態。
印出「清理完成」不算。雲端 API 接受刪除請求,也還不算。要查到最後的狀態。
失敗也得驗證。任務失敗後有沒有清理?清理又失敗,有沒有留下資源識別碼,讓人知道還有什麼沒處理?
Agent 可以換實作方式,但不能把這些預期一起改掉。
這樣測試才會形成回饋:它知道哪一段沒符合預期,修改後再跑一次。否則每次都由我告訴它哪裡不對,Agent 的工作就還沒辦法離開我的即時指揮。
跑得完,還要知道跑得怎麼樣
資源內部的狀態也要看:使用率、記憶體用量、任務耗時、等待時間、錯誤紀錄。
任務最後成功,過程卻可能大半時間都在等待,或記憶體用量持續增加,直到任務結束才釋放。只看最後一個成功狀態,這些問題都看不到。
E2E 確認流程有沒有照預期走,這些指標則幫我看效率。要比較修改前後的效能,環境與負載也得能比較,不能只看一次跑得比較快。
如果要讓 Agent 改善效率,就得先定義這次要改善什麼、要留下哪些量測。否則改了一段看起來比較快的程式,也很難說明整個任務到底有沒有變好。
困難的是,錨點本身也要可靠
比較難的,是把這些接成可重複執行的流程。測試資料怎麼準備、環境怎麼啟動、失敗去哪裡查,都要清楚。否則連測試失敗是程式有問題,還是環境不穩,都分不出來。
像雲端資源啟動需要等待,測試就得知道什麼狀態算準備好、等多久算逾時。只加一段固定等待,這次通過了,下次可能又失敗。Agent 拿到不穩定的結果,也就沒有可靠的依據可以修正。
比較實際的方式,是在期限內持續查詢狀態,遇到明確失敗就停止;逾時則留下最後一次狀態與錯誤。也要分開記錄「環境沒有成功啟動」和「啟動後的行為不符合預期」,保留線索,不能把重跑到通過當成問題解決。
這也是 DevOps 要補的功課。需求、實作、測試、部署、監控要接得起來。每次還得由我把 log 和指標搬給 Agent,它就只能做到我醒著、有空幫忙的地方。
雲端測試有成本,可以先用快速測試檢查局部邏輯,再把關鍵流程放到有範圍、費用上限的環境跑 E2E。
完整度要看重要行為有沒有涵蓋。每一種輸入都跑一次真正的雲端流程,未必划算;但只測成功路徑,又會漏掉任務失敗、清理失敗這些真正需要處理的事。
不過,測試環境穩定、流程跑得完以後,還有一個更根本的問題:測試裡的預期,本身就是對的嗎?
工程師的責任往上移,方法論值得重新理解
以前寫程式,時間和人力有限,很多事情得取捨。規格不夠完整、測試漏掉情境、文件跟不上程式,不是不知道重要,而是做好它們需要成本。
AI 可以協助整理文件、產生測試、理解既有程式碼,讓這些工程實踐更容易落實。
但產出變便宜,不代表判斷也變簡單。文件可以寫得很完整,卻完整地描述了一個錯誤需求。我們還是得回答:在解決誰的問題?哪些規則不能破壞?什麼結果才足以驗收?
當實作成本下降,工程師的責任也往上移:定義問題、設計規格、協調 Agent,以及驗證結果。
以前工程師抱怨需求不完整,要猜 PM 的意思。現在自己帶 Agent,也得面對同一件事:我交代得夠清楚嗎?它做出來的,是我要的嗎?
這些問題,既有的方法論其實已經處理很多年了。
DDD 釐清領域,SDD 定義規格,BDD 對齊行為,TDD 用測試推進實作。它們處理不同層次的問題,也會互相影響,不是四選一。
我目前最想下功夫的是 SDD 和 BDD。規格讓 Agent 有依據,具體的行為情境則讓我們確認,彼此想的是不是同一件事。用前面的算力派發來看,這幾種方法各有要處理的問題。
預期沒有說清楚,測試寫再多,也可能只是在替錯誤的理解背書。
DDD:先講同一種話
以前團隊對「任務完成」理解不同,可能在討論或 Code Review 時才發現。現在交給多個 Agent,同一個詞可能被各自解釋,再分別寫進程式與測試。
任務執行結束、結果保存、資源清理,是同一個狀態,還是不同責任?DDD 要釐清的共同語言與模型邊界,在這裡就很具體。先把它們拆清楚,Agent 才不會各自做出合理、接起來卻矛盾的實作。
SDD:把決定寫下來
只在某次對話交代「跑完要清理」,換一個 Agent、另一個工作階段,這個決定就可能沒被帶過去。
SDD 對我的用途,是讓需求、限制與驗收條件能持續被引用。用哪個雲端、結果存哪裡、只清理誰建立的資源,都有共同依據。
規格也要跟著需求修改,並在交付時核對。否則只是更有效率地照著過時的決定做事。
BDD:拿具體情境來談
「錯誤處理要做好」,Agent 可以補上一個 catch 就認為完成。BDD 讓我們在實作之前,先拿具體情境確認大家要的是不是同一件事:
- 假設資源是本次任務建立的。
- 當任務執行失敗。
- 系統要保存失敗紀錄、嘗試釋放資源,分別留下任務與清理的結果。
清理也失敗,就要知道哪個資源還在。重點是對預期取得共識,Given/When/Then 是表達方式。
這讓我們有機會在產生大量程式之前,先發現需求理解的落差;確認過的案例,也能成為 Agent 反覆核對的驗收依據。
TDD:先看到測試失敗
如果讓同一個 Agent 一口氣寫功能和測試,它可能照著自己的實作補出一套全綠的檢查,卻沒有碰到真正要守住的行為。
TDD 的先失敗、再通過、再重構,在這裡多了一個很實際的用途:先寫出能抓到「任務失敗卻沒清理」的測試,看到它因為缺少這個行為而失敗,再讓 Agent 實作。至少先確認,這個檢查抓得到我們在意的問題。
功能寫完再補測試仍然有價值,但那是另一種做法。
目的地講清楚,車道也要劃好
能驗證成果,不代表就能把所有權限交出去。前面說任務失敗要清理,如果 Agent 理解成「把這個環境清乾淨」,刪到別人的資源,測試還沒跑完,事故就先發生了。
所以「只清理本次建立的資源」不能只寫在 prompt。可以把 Agent 能操作的帳號、環境與資源範圍限制在工具端,刪除前核對任務與資源的歸屬;範圍不明,就停下來回報。標籤可以協助追蹤,但不能單靠一個標籤就決定誰有權刪除。
建立資源也一樣,需要限制類型、數量、存活時間與執行期限。預算告警只是通知,不一定會阻止支出;真正要限制建立或中止執行,還得有對應的控制。超出範圍的操作,再交回人決定。
這些是我認為往自動化發展時必須補上的條件。Agent 就算判斷錯,也要讓影響留在可承受的範圍。
多個 Agent,不能只靠大家小心
多個 Agent 同時修改同一份檔案,很容易互相覆蓋。但就算沒碰同一份檔案,也可能各自改了介面的一端,合起來才發現行為對不上。
這時候,資料夾結構、模組邊界與分層就很重要。任務派發、雲端操作、結果保存如果責任混在一起,每個需求都得動到同一大塊程式,工作就很難拆開。
例如,可以讓核心流程依賴共同介面,把各家雲端的操作放進不同的 Adapter。新增資源支援時,Agent 有比較明確的修改範圍;要改共同介面,則先協調,再讓相關實作一起跟上。設計模式在這裡的用途,是減少修改互相牽動。
分派時也要說清楚各自負責的模組與檔案,共用設定、介面或資料結構由誰統整。分支或 worktree 可以隔離各自的工作目錄,但最後仍要依序整合,跑過跨模組的檢查;沒有 Git 衝突,不代表沒有系統行為的衝突。
我覺得這也是系統設計在 AI 時代更值得做好的原因:責任邊界清楚,工作才比較能平行。原本靠同事默契補起來的地方,交給 Agent 之後,都得重新說清楚。
花這些錢,值得嗎?
每月超過一萬美元,是我目前的投入,不是每個團隊都需要的預算。每週一百多個 PR,也不能直接換算成產值:修改拆得更細、反覆修同一個問題,都可能讓數字增加。
我覺得值得追的,是符合預期的修改交付了多少、我花多少時間驗收、合併後又花多少時間返工。還要算模型費用、測試雲端資源,以及維護這套流程的人力。省下寫程式的時間,卻增加更多檢查與善後,帳未必划算。
目前我沒有整理出足以做前後對照的量測,所以這些支出與 PR 數量,只能交代我的使用規模,不能證明投資報酬。
如果未來同等能力的 token 成本下降,讓更多 Agent 平行嘗試,或多跑幾輪驗證,可能會更划算。但只要每份結果仍然要人從頭看,便宜的產出還是會堆在驗收前面。模型費用下降,可能讓人的注意力更快成為主要成本。
驗證基礎設施也得算回收。偶爾改一次的小工具,不一定值得先建完整環境;常改、容易出錯、每次都得人工確認的關鍵流程,才更值得把操作與驗收自動化。先解掉反覆出現的成本,再擴大投入。
我睡覺的時候,它能不能繼續做?
這是我接下來想做的方向,還沒有完整串起來。
新功能可以從規格開始。例如,新增一種雲端資源,先定義介面與啟動、執行、清理的行為,再讓 Agent 實作、補測試與文件,確認新舊流程都能跑,提出 MR/PR。
維運則可以從告警開始。Sentry 或 Alertmanager 收到問題,由定期任務合併重複告警,整理版本、環境、錯誤紀錄與重現方式,建立 Jira 工作項目,再交給 Agent 調查。
「雲端任務失敗」只是線索。資源沒建起來、還沒準備好就執行、失敗後沒清理,原因不同,也不一定都要改程式。
能重現,就先建立能抓到問題的檢查,再修復。不能重現,就留下線索與缺少的條件,不要硬湊一個修正。
隔天我要看到的,是一份能審查的修改:改了什麼、為什麼改、驗證了什麼、還有什麼不知道。
預期還是得有人負責
規格、實作和測試如果都來自同一個錯誤理解,最後照樣可以全綠。
驗證證據也有範圍。「這次任務失敗後,資源確實被釋放」,只能支持這個情境的結論,不能直接變成「整套算力派發都沒問題」。
需求與關鍵案例還是得由人確認。Agent 改功能時也改了驗收測試,要看清楚:是案例過時,還是它把標準放寬了?
經常重複提醒的型別限制、依賴方向、架構規則,能放進工具和 CI 的就放進去,別每次都靠人記得。
每次 Code Review 都在提醒同一條規則,就值得想:能不能讓系統自己檢查?省下來的注意力,才能留給需求、取捨與那些工具還無法回答的問題。
我會先從一個任務開始,把預期講清楚,讓它跑完驗證,再看自己還卡在哪裡。
不需要每個小修改都先寫一大包規格。先挑常出錯的流程,留下關鍵案例、操作方式與證據,再逐步補上 Agent 還會猜錯、漏掉的地方。
驗收跟得上,Agent 軍隊才帶得動。
參考資料
- Lauren Tan 的分享錄影:信任與平行工作,是促使我思考 Agent 驗證能力的起點。
- PStack 驗證文件與 feature map 範例,把操作方式、預期結果與證據整理成可重複使用的路徑。
- Eric Evans 的 DDD 資源、Microsoft 的 SDD 文章,以及 Dan North 的〈Introducing BDD〉,可進一步對照這些方法的概念與脈絡。
- Sentry 的外部工作項目 API、Alertmanager 的告警處理與 webhook 設定,是未來串接工作流程時可以參考的工具文件。
分享這篇文章

Copyright © 2026 程人頻道. All rights reserved.